
SITCON Camp 2026 ML 課程
教學
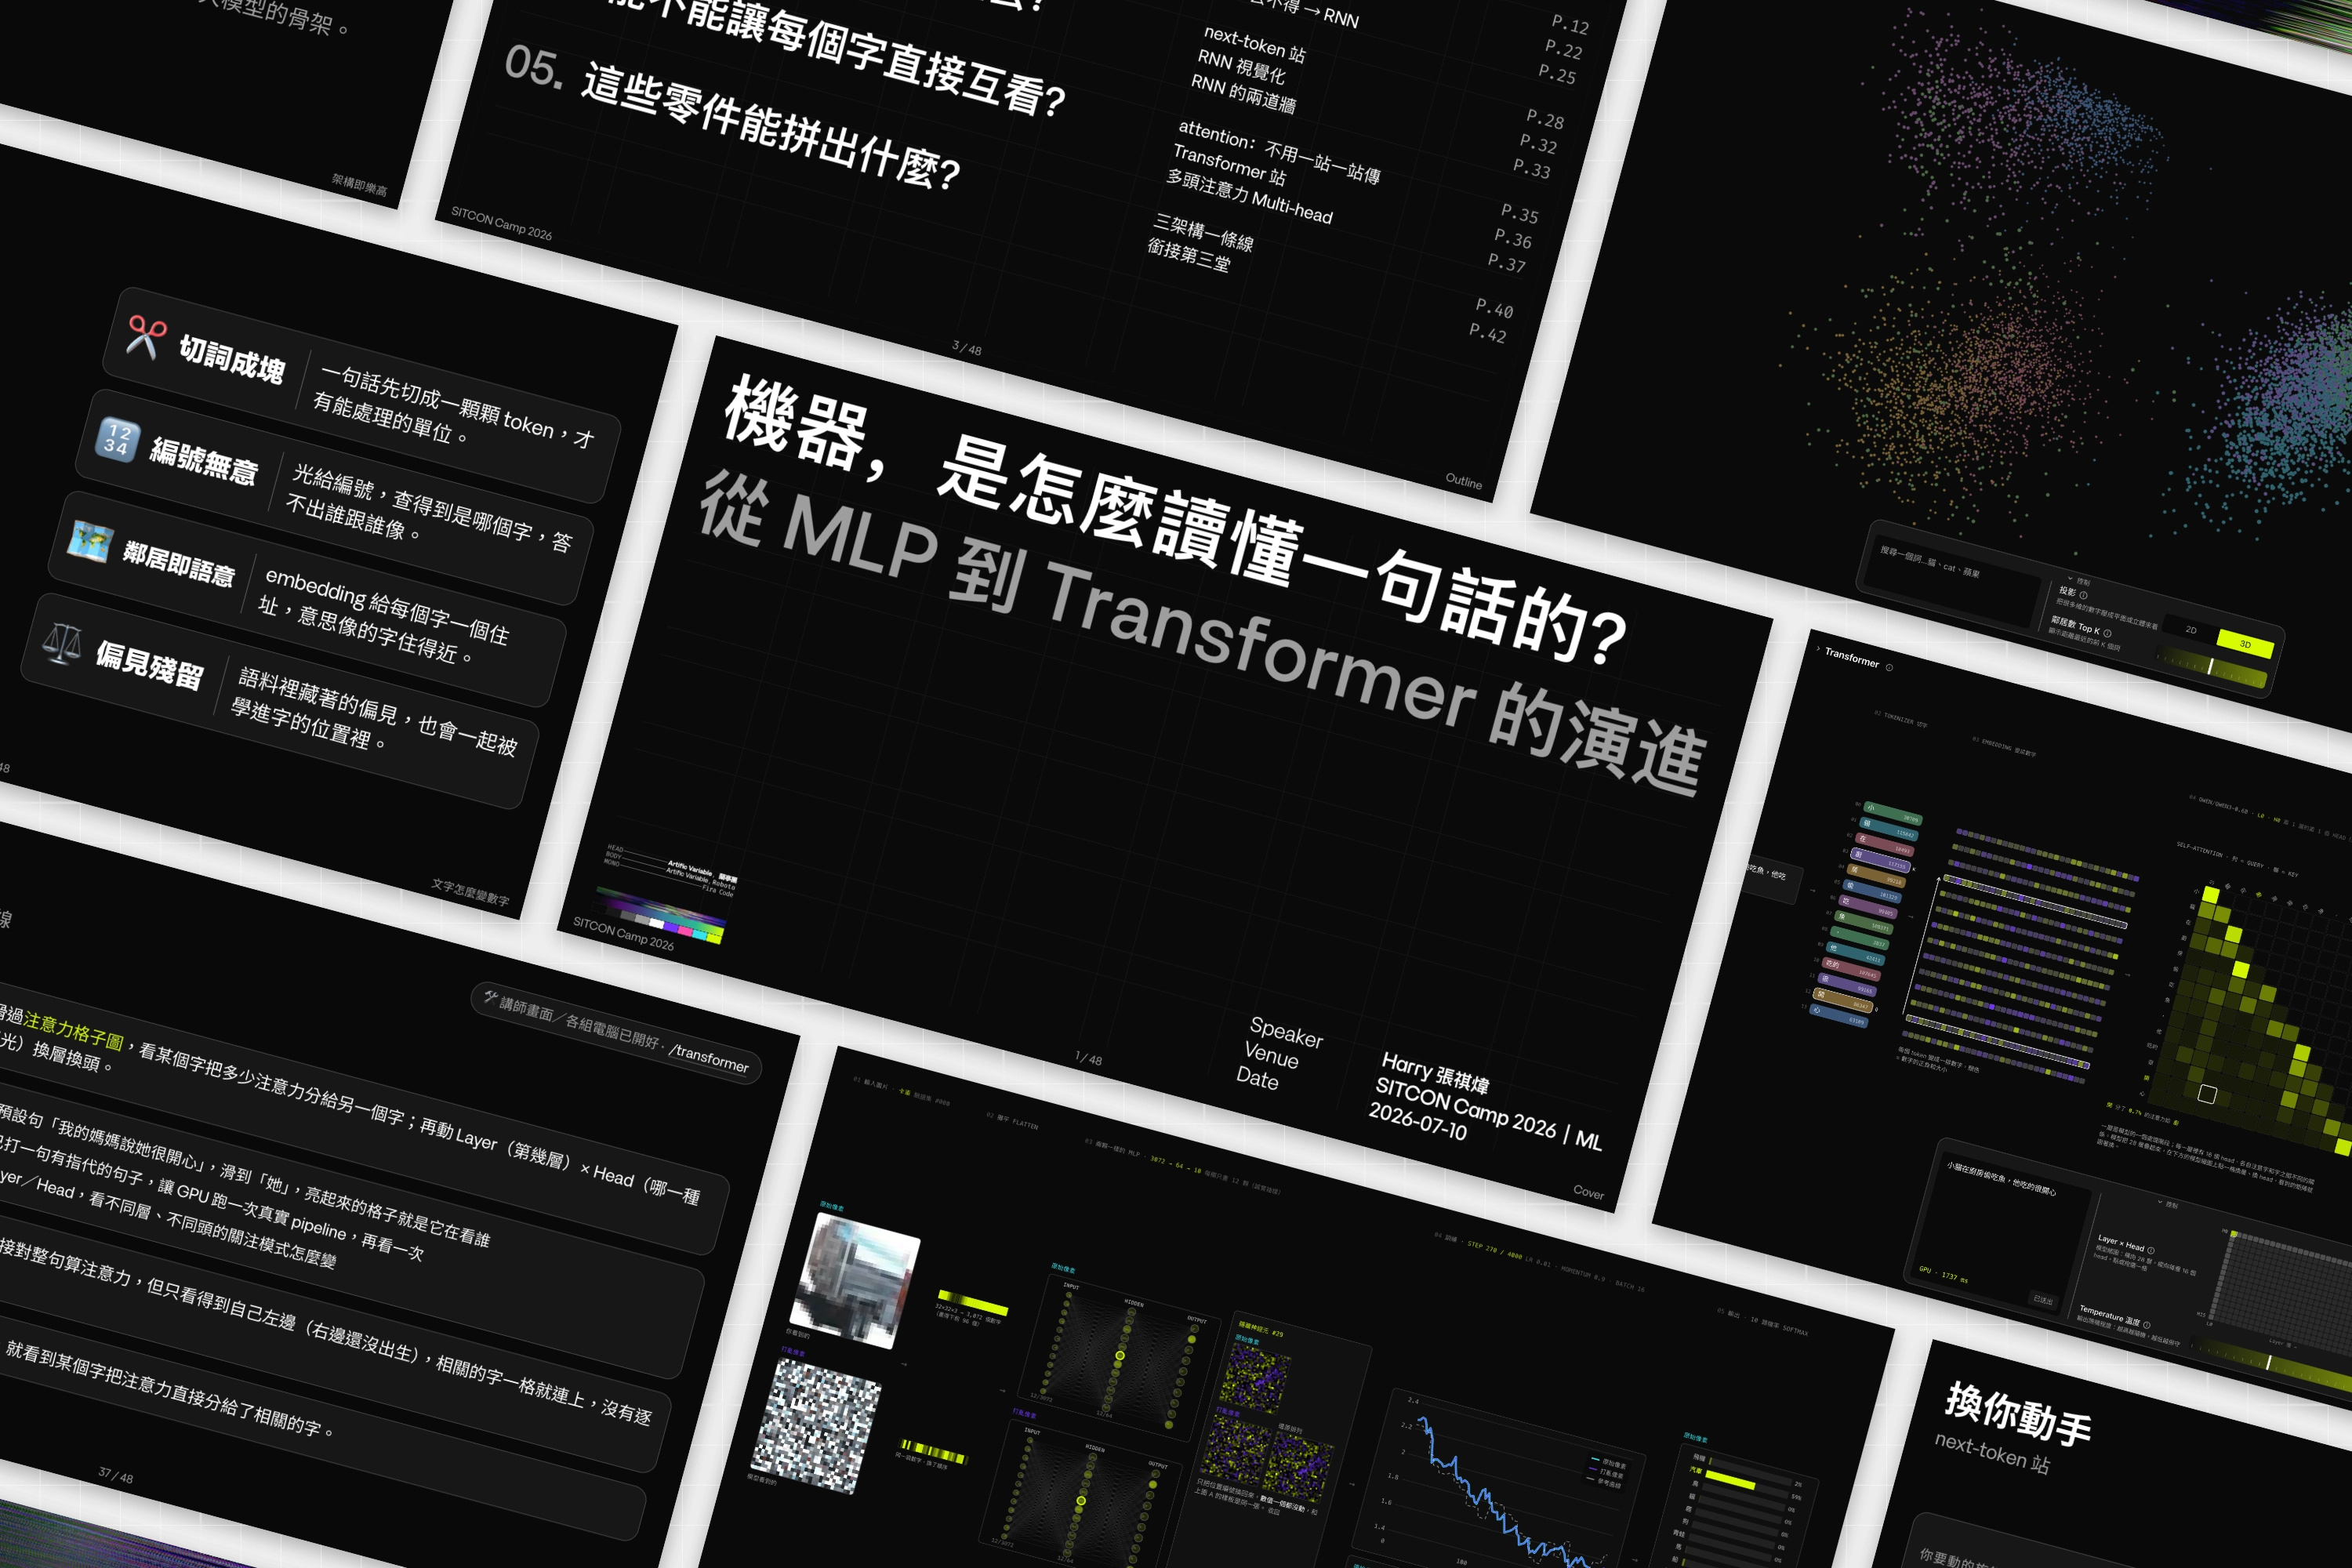
為高中生設計的三小時課程,沿著 MLP → RNN → Transformer 的脈絡走,整堂課都建立在我親手設計與開發的互動式關卡上,背後由一台跑著真實 Qwen 模型的 GPU 推論伺服器支撐。
Year
2026
Role
講師、設計師與開發者
Technologies
React, TypeScript, PyTorch, FastAPI
專案概覽
SITCON 是臺灣最大的學生開發者社群年會,我曾兩度站上它的年會舞台,分別談了 2025 年的 RAG 與 2026 年的提示注入。SITCON Camp 是它的暑期營隊,而這次我站到了教室的另一邊:設計、開發並教授了下午的機器學習軌,一堂三小時、名為 機器,是怎麼讀懂一句話的?從 MLP 到 Transformer 的演進 的課程,於 2026 年 7 月 10 日進行。
比較不尋常的是,這堂課很少「看投影片、聽講解」的段落。課程本身活在六個互動式關卡裡,也就是學生可以直接動手戳的瀏覽器畫布,而整個專案從空白 repo 到營隊當天,只花了十七天。
教學設計:先讓他們撞牆
整堂課建立在同一個循環上:給一個問題 → 讓他們卡住 → 讓他們做出還可以的結果 → 把問題變難 → 新的概念以「救他們的東西」的身分登場。 沒有任何東西是以定義的形式被介紹的。每一個架構之所以出現,都是因為前一個架構在他們眼前壞掉了。
由此延伸出兩個限制。第一,不用 Colab:在 notebook 裡,學生大可以直接把練習丟給 AI agent,整堂課的節奏就崩了。第二,環境即引導,介面本身就該把學生推向那個洞見,而不是靠我在台上講出來。學生依序走過每個關卡,我則從一台控制終端逐關解鎖,避免有人先跑到終點。
Tokenizer。 打一句話,看它碎掉。字元、詞、BPE 三種切法並排呈現,說明模型從來看不到字元,只看得到 token。
Embedding。 一個中英共用的語意空間,可以在 2D 或 3D 裡自由漫遊。輸入任何一個詞,它會飛向自己的鄰居。關卡最後收在 man:king :: woman:? 的偏見例子上,在前面十分鐘空間都顯得中性而數學之後,這一擊才真的打得進去。
打亂像素。 這是撐起後面所有內容的那道牆。我請全班先篤定:如果 CIFAR-10 每張圖的每一顆像素都依同一個固定排列被打亂,早上由 AK 帶他們訓練的那個 MLP,還學得起來嗎?多數人說不行。接著兩個完全相同的 MLP 在瀏覽器裡並排訓練,一個吃原始像素、一個吃打亂後的像素,兩條 loss 曲線完全疊在一起。對 MLP 來說,像素的位置只是一個接線編號,詞的順序也是同一回事。這個架構裡根本沒有「順序有意義」這個假設。
猜下一個 token。 學生用模型的規則跟模型對玩,在機率分布揭曉前先猜下一個詞,並逐步放寬可見的上下文,直到「看得更多就猜得更準」變成一件顯而易見的事。
RNN 視覺化。 一個隱藏狀態沿著序列流動,一次一個 token 地把記憶往前帶。接著這個關卡直接攤開通往下一步的兩道牆:長上下文會被稀釋,訓練會不穩定。
Transformer。 前面所有內容都是為了換到這一關。一句話由左至右橫跨整個畫面,從 tokenizer 到 embedding,到即時計算的 self-attention 矩陣,再到輸出的機率分布,而且每一段都是真的 Qwen3-0.6B,不是示意圖。學生輸入自己的句子,然後在 28 × 16 的 layer 與 head 網格上拖曳,看注意力的樣態在游標底下不斷重組。注意力不再是論文裡的一張圖,而變成一種有紋理、可以親手去翻找的東西。
在這條主線之外,還有一區不上鎖的全景支線任務,目的是讓大家知道 ML 遠比我們花三小時拉的這條線更大:LoRA 人格轉換、擴散生成圖、Feature Steering、文字生 3D、自我對弈的 RL 競技場,還有從衛星影像長出一座能飛進去的城市的 Skyfall-GS。
簡報
投影片負責把關卡之間的敘事接起來,而這次它們終於不是 Affinity 加 Keynote 了。整份簡報用 Marp 製作,也就是用純 markdown 編譯成 HTML,因為課程簡報在最後一週會以小時為單位被改寫,手動重新匯出 4K 切片絕對會拖垮進度。為了不讓它看起來像個通用模板,我先把自己那場 SITCON 2026 議程的視覺語言蒸餾成一份設計系統,再把它實作成 Marp 主題。簡報裡的每一張圖表都由十九支 Python 腳本之一產生,所以數字改了就重跑,而不是重畫。
技術架構
最高原則是瀏覽器永不訓練。所有重運算都由 Python pipeline 事先算完,匯出成體積很小的 JSON 與 ONNX 產物,關卡只負責重播它們或跑輕量推論。「打亂像素」是唯一一個刻意的例外,它的兩個小網路是在 Web Worker 裡即時訓練的,因為重播一條事先準備好的曲線會把整堂課的說服力降低。前端是一個 pnpm/Turborepo monorepo:一個 Next.js shell、一個裝著所有關卡的 Vite SPA,加上版面、視覺化元件與產物載入這三個共用套件。
真正有趣的問題是自訂輸入。一個只能跑我預設五句話的學生並不是在探索,所以我用 FastAPI 架了一個服務,跑的是與 precompute pipeline 完全相同的模型(Qwen3-0.6B 負責 next-token 機率分布與真實注意力,Qwen3-Embedding-0.6B 負責語意空間),任何人打什麼它都答得出來。兩邊呼叫的是同一份 helper,並遵守一份寫成文件的決定性契約:float32、eager attention、不取樣、輸出四捨五入,因此現場輸入一句預設 prompt,會重現出與內建產物完全一致的數值。
有兩種失效模式比單次請求的延遲更重要。任何情況下都不能把全班卡死:伺服器掛掉、連不上、或觸發限流時,每個關卡都會靜靜退回自己的預運算產物,課照樣上下去。以及它必須撐得住五十個人同時按同一顆按鈕。單一 process 會用鎖把 GPU 工作序列化,因此在 attention 路由上做同步爆量測試時,中位數落在 2.45 秒,這個長度足以讓整間教室散掉;改成四份未經修改的相同程式、每份綁定一張 V100,前面掛一層以在途請求數做負載平衡的 Caddy,中位數降到 0.46 秒。包在這一切外面的是課堂機制:每位學生的獨立帳號、可以一鍵鎖住所有螢幕或把全班跳到同一關的控制終端、由伺服器驗證的關卡任務,以及一個公開排小隊名次、但刻意不公開個人分數的排行榜。
現場成效
基礎設施是營隊當天最無聊的一環,而這是我能給它的最高評價。Grafana 從頭到尾沒有跳過一次,GPU 使用率整個下午低到有點出乎意料,所以那套水平擴展終究是一份我沒用上的保險。
「打亂像素」是我會改進的那一關。走到它的時候我們已經稍微落後進度,於是這一關塌陷成我在台上示範,而不是全班先押注、再看著自己被推翻。內容還在,但讓內容真正黏住的那個機制不見了。「先讓他們撞牆」不只是設計上的承諾,更是排程上的承諾,因為在時間不夠的那一刻,你砍掉的往往正是真正在教學的那一段。
Transformer 關卡則是整堂課回本的地方。學生真的在 layer 與 head 的網格裡到處翻找 previous-token head,也真的找到了;還有幾個人對某個 head 在做什麼給出了篤定但錯誤的解讀,而那些誤解對整間教室的價值遠高於正確答案,因為它們具體到足以被當眾拆開來看。這正是整堂課押的注:把一個真實模型的蓋子掀開放到十五歲的人面前,他們追一個自己想出來的問題,會比追一個我遞給他們的問題走得遠得多。
致謝
感謝 AK,他帶的早上那堂課,正是我的下午場被設計來接續的起點;也感謝 SITCON Camp 2026 籌備團隊,願意信任我從零把這一軌長出來。同時感謝在營隊前幫忙壓測關卡、抓出許多我一個人不可能找到的失效情境的夥伴們,以及同為營隊講者的李杰穎,衛星關卡正是建立在他的 Skyfall-GS 之上。